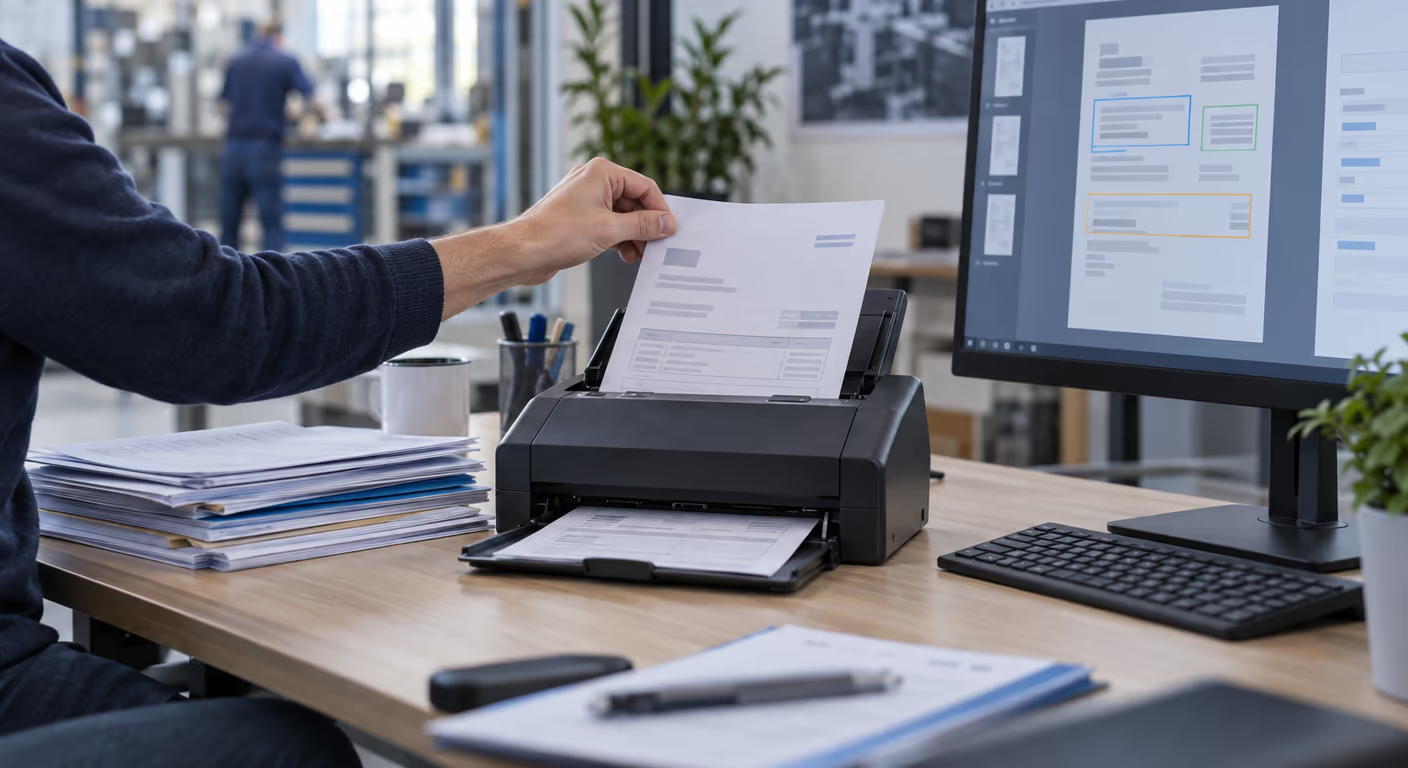
Traitement intelligent des documents (IDP)
· par Panayot Dimkov
Le traitement intelligent des documents (IDP) utilise l'IA pour faire avec un document ce que fait aujourd'hui une personne : le classer, en extraire les données utiles, les valider face aux systèmes de l'entreprise et décider de leur destination, avec un niveau de confiance par champ qui indique quand une vérification humaine est nécessaire. L'OCR n'est qu'une brique de ce processus : il convertit l'image d'un texte en caractères, mais il ne comprend pas quel document il a devant lui, ne sait pas lequel de ces nombres est le total et ne remarque pas qu'une donnée manque.
1Les quatre couches du traitement intelligent des documents
Un traitement complet fait quatre choses distinctes, et il vaut mieux les séparer car chacune a sa difficulté.
2Les documents d'une entreprise ordinaire
On pense aux factures parce qu'elles sont les plus visibles, mais le volume réel est réparti.
| Document | Ce qui est extrait et pourquoi |
|---|---|
| Bons de livraison | Numéro de commande, références et quantités, pour rapprocher de la commande et valider la réception |
| Certificats et assurances | Titulaire, portée et date d'expiration, pour alerter avant l'échéance au lieu de le découvrir au moment où l'on en a besoin |
| Contrats | Parties, montant, durée, préavis de renouvellement. La reconduction tacite non souhaitée est un classique coûteux |
| Fiches d'intervention | Heures, matériaux et signature du client, souvent manuscrits et photographiés au téléphone |
| Justificatifs de frais | Montant, date, objet et TVA, pour rembourser sans que personne ne ressaisisse de tickets |
La liste compte car elle change l'ordre des priorités. Une alerte automatique d'expiration de certificats peut valoir plus que gagner des minutes sur les factures, et c'est généralement plus simple à monter.
3IDP ou OCR : pourquoi les gabarits ne suffisent plus
L'OCR à gabarits fonctionne par coordonnées : il apprend que dans les documents du fournisseur A le total est en bas à droite. C'est précis et rapide tant que le document ne change pas.
- Chaque nouvelle mise en page est du paramétrage. Avec vingt émetteurs c'est tenable ; avec deux cents, quelqu'un ne fait plus que cela.
- Une refonte casse le gabarit. Le fournisseur déplace son logo et l'extraction se met à échouer sans prévenir.
- Il ne comprend pas les variantes. Un bon de livraison sur deux pages, un tableau coupé ou une note manuscrite en marge sortent du moule.
- Il ne sait pas ce qu'il ignore. Il renvoie ce qui se trouve à cette position, que ce soit la bonne donnée ou non.
Un modèle de langage doté de vision fonctionne à l'inverse : il interprète le document comme le ferait une personne, d'où sa capacité à gérer des mises en page nouvelles sans paramétrage. En contrepartie il est moins déterministe, d'où le point suivant.
4Le niveau de confiance est la donnée qui compte
La question que tout le monde pose — « quelle précision ? » — est la moins utile. La bonne est : le système sait-il quand il n'est pas sûr ?
Il n'y a pas de seuil universel : il se fixe champ par champ, sur un échantillon réel de documents, plus exigeant pour une date d'expiration ou un montant que pour une référence interne. Et une confiance élevée ne garantit pas que la donnée soit juste ; c'est pourquoi la couche de validation reste nécessaire.
Corollaire pratique : la révision humaine n'est pas un échec de conception, elle en fait partie. Et l'interface de révision compte autant que le modèle : si corriger un champ prend trois clics avec le document à côté, les gens le font ; s'il faut ouvrir deux écrans, non.
5Les cas difficiles, avec des attentes réalistes
6Comment choisir le premier cas
Quatre critères, dans cet ordre :
Questions fréquentes
Quelle différence entre l'OCR et le traitement intelligent des documents ?
L'OCR transforme une image en texte : il reconnaît des caractères. Le traitement intelligent ajoute trois choses : comprendre de quel type de document il s'agit, localiser les champs porteurs de sens même s'ils bougent, et valider l'extrait face aux données de l'entreprise. L'OCR est un composant du second, pas un substitut.
Faut-il entraîner le système sur mes documents ?
Avec les modèles actuels, pas pour démarrer. Ils reconnaissent les types de documents courants sans paramétrage, ce qui est la grande différence avec les gabarits. En revanche, il est utile d'affiner avec vos exemples les types propres à votre secteur et les règles de validation, qui dépendent de votre activité.
Peut-il traiter des documents en plusieurs langues ?
Oui, dans les langues courantes et sans paramétrage distinct pour chacune. C'est une différence notable avec les solutions à gabarits, où chaque langue impliquait généralement une configuration à part. Pour une entreprise avec des fournisseurs ou des clients dans plusieurs pays, cela supprime une bonne part de la maintenance.
Où les documents sont-ils traités ?
Cela dépend du service utilisé, et c'est une question à poser avant de signer. Si les documents contiennent des données personnelles — et presque tous en contiennent — il faut savoir si le traitement sort de l'Espace économique européen et sous quelle garantie, et disposer du contrat de sous-traitance. Nous le détaillons dans automatiser des processus sans enfreindre le RGPD.
Et les vieux documents papier ?
Une numérisation de masse ne se justifie que s'ils seront réellement consultés. Il est souvent plus raisonnable de traiter à partir d'aujourd'hui et de numériser l'historique à la demande. Une exception : s'il existe une obligation de conservation et que l'archive physique est un risque, la numérisation a une autre justification.
En résumé
Le saut par rapport à l'OCR ne tient pas à mieux lire, mais à comprendre le document et à savoir quand on n'est pas sûr. Cela permet d'arrêter de paramétrer des gabarits et de concevoir un flux avec des seuils, des validations et une petite file de révision.
Et il vaut la peine de regarder au-delà des factures : les certificats qui expirent, les contrats qui se reconduisent seuls et les fiches d'intervention que personne ne ressaisit rapportent souvent davantage et sont plus faciles à traiter. C'est ainsi que nous abordons l'automatisation des processus par l'IA.
Quels documents entrent chaque semaine dans votre entreprise ?
Avec un échantillon réel des types que vous manipulez, on peut estimer la part traitée sans intervention et ce qu'il faudrait valider. Nous l'examinons avec vous.
Demander une analyse des processusNexum Blog
Articles associés
17 juin 2026
SCADA vs IHM : différences et lequel choisir
Différence entre SCADA et IHM : périmètre, historiques, alarmes, accès distant et quand choisir chacun. Un guide clair d'un intégrateur industriel.
31 juil. 2026
Choisir un fabricant d'armoires électriques industrielles
Comment choisir un fabricant d'armoires électriques industrielles : IEC 61439, FAT, bureau d'études, les 7 questions clés et les signaux d'alerte.
9 juil. 2026
Tendances de l'Industrie 4.0 en 2026
Les 8 tendances de l'Industrie 4.0 en 2026 qui comptent vraiment : IA en usine, vision artificielle, jumeaux numériques, cobots, edge et NIS2.