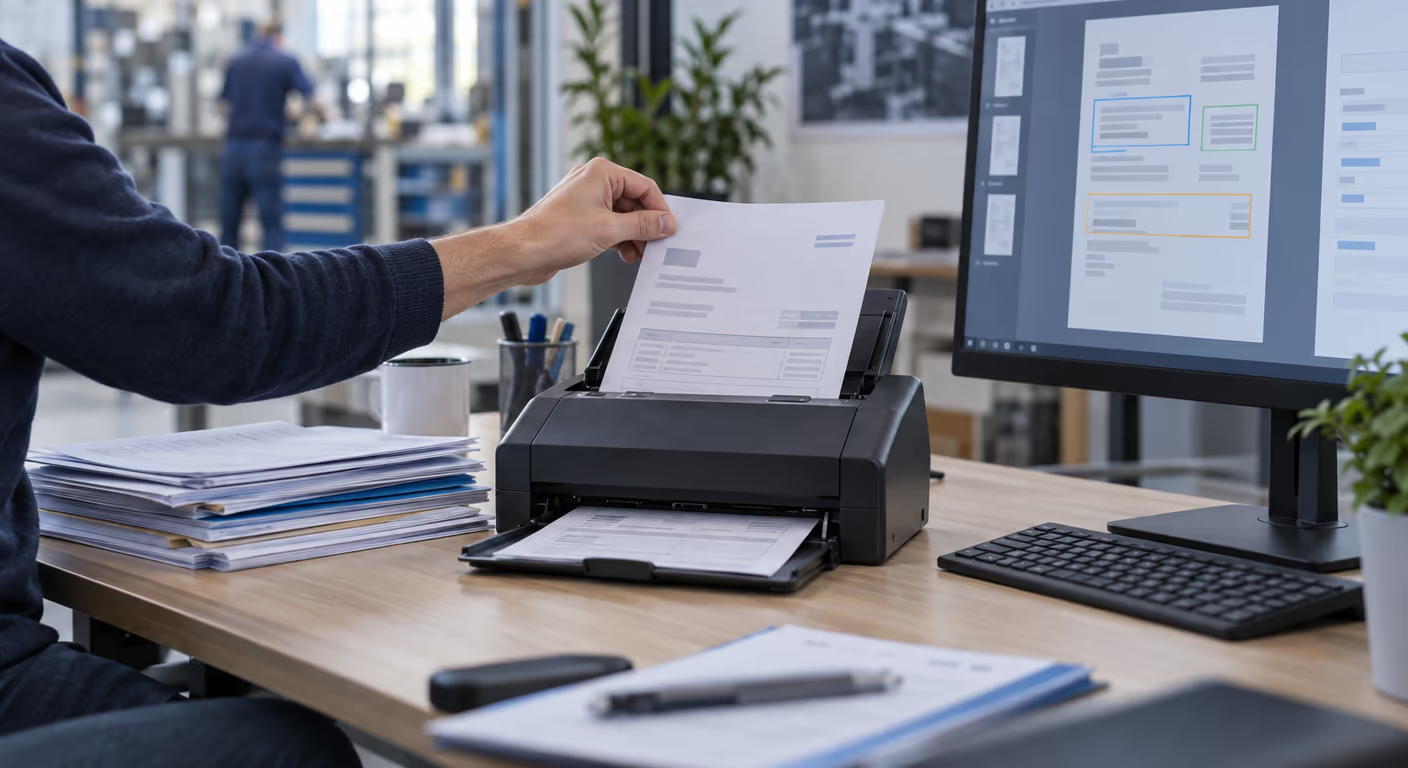
Интелигентна обработка на документи (IDP)
· от Panayot Dimkov
Интелигентната обработка на документи (IDP) използва изкуствен интелект, за да прави с документа онова, което днес прави човек: да го класифицира, да извлече важните данни, да ги провери спрямо системите на компанията и да реши къде да отидат, с ниво на увереност за всяко поле, което показва кога е нужен човешки преглед. Оптичното разпознаване на символи (OCR) е само част от този процес: превръща изображение на текст в символи, но не разбира какъв документ вижда, не знае кое от числата е общата сума и не забелязва, че липсва поле.
1Четирите слоя на интелигентната обработка на документи
Пълната обработка прави четири различни неща и е добре да се разграничат, защото всяко има своята трудност.
2Документите в една обикновена компания
Мисли се за фактурите, защото са най-видими, но реалният обем е разпределен.
| Документ | Какво се извлича и защо |
|---|---|
| Стокови разписки | Номер на поръчка, артикули и количества, за съпоставяне с поръчката и потвърждаване на полученото |
| Сертификати и застраховки | Титуляр, обхват и дата на изтичане, за да се предупреди преди изтичане, а не да се открие, когато потрябват |
| Договори | Страни, сума, срок, предизвестие за подновяване. Нежеланото автоматично подновяване е скъпа класика |
| Работни фишове | Часове, материали и подпис на клиента, често ръкописни и снимани с телефон |
| Разходооправдателни документи | Сума, дата, основание и данък, за да се приключват отчети, без никой да преписва касови бележки |
Списъкът има значение, защото променя приоритетите. Автоматично известие за изтичащи сертификати може да струва повече от спестени минути по фактурите и обикновено е по-лесно за изграждане.
3IDP срещу OCR: защо шаблоните вече не стигат
Разпознаването с шаблони работи по координати: научава, че в документите на доставчик А общата сума е долу вдясно. Точно и бързо е, докато документът не се промени.
- Всяко ново оформление е настройка. С двадесет издатели е поносимо; с двеста някой се занимава само с това.
- Един редизайн чупи шаблона. Доставчикът мести логото си и извличането започва да греши без предупреждение.
- Не разбира варианти. Стокова разписка на две страници, накъсана таблица или ръкописна бележка в полето излизат от калъпа.
- Не знае какво не знае. Връща каквото стои на тази позиция, вярно или не.
Езиковият модел със зрение работи обратно: тълкува документа както би го направил човек и затова се справя с нови оформления без предварителна настройка. В замяна е по-малко предсказуем — оттам следва и следващата точка.
4Нивото на увереност е важното число
Въпросът, който всички задават — „каква е точността?“ — е най-безполезният. Добрият е: знае ли системата кога не е сигурна?
Универсален праг няма: определя се за всяко поле и с реална извадка от документи, като е по-строг за дата на изтичане или сума, отколкото за вътрешен референтен номер. А високата увереност не гарантира, че стойността е вярна — затова слоят за проверка остава необходим.
Практическото следствие е, че човешкият преглед не е провал на проектирането, а част от него. И че интерфейсът за преглед има същото значение като модела: ако корекцията на едно поле е три щраквания с документа отстрани, хората я правят; ако изисква два отворени екрана — не.
5Трудните случаи, с реалистични очаквания
6Как да изберете първия случай
Четири критерия, в този ред:
Често задавани въпроси
Каква е разликата между OCR и интелигентна обработка на документи?
OCR превръща изображение в текст: разпознава символи. Интелигентната обработка добавя три неща отгоре: разбиране какъв е документът, намиране на смислените полета дори когато се местят, и проверка на извлеченото спрямо данните на компанията. OCR е компонент на второто, не негов заместител.
Трябва ли да обучавам системата с моите документи?
Със съвременните модели — не, за да започнете. Те разпознават често срещаните видове документи без предварителна настройка, което е голямата разлика спрямо шаблоните. Струва си обаче да се донастроят с ваши примери специфичните за бранша видове и правилата за проверка, които зависят от вашия бизнес.
Може ли да обработва документи на няколко езика?
Да, на обичайните езици и без отделна настройка за всеки. Това е съществена разлика спрямо решенията с шаблони, при които всеки език обикновено означаваше отделна конфигурация. За компания с доставчици или клиенти в няколко държави това премахва голяма част от поддръжката.
Къде се обработват документите?
Зависи от използваната услуга и е въпрос, който се задава преди подписване. Ако документите съдържат лични данни — а почти всички съдържат — трябва да се знае дали обработването напуска Европейското икономическо пространство и с каква гаранция, както и да има договор с обработващ данни. Разглеждаме го в автоматизация на процеси без нарушаване на GDPR.
А старите документи на хартия?
Масовото цифровизиране си струва само ако наистина ще бъдат преглеждани. Обикновено е по-разумно да се обработва отсега нататък, а историята да се цифровизира при нужда. Едно изключение: ако има задължение за съхранение и физическият архив е риск, цифровизирането има друго основание.
В крайна сметка
Скокът спрямо OCR не е в по-доброто разчитане, а в разбирането на документа и в знанието кога не си сигурен. Това позволява да се спре настройването на шаблони и да се проектира поток с прагове, проверки и малка опашка за преглед.
И си струва да се гледа отвъд фактурите: изтичащите сертификати, договорите, които се подновяват сами, и работните фишове, които никой не преписва, обикновено връщат повече и са по-лесни за подхващане. Точно така подхождаме в автоматизация на процеси с изкуствен интелект.
Какви документи влизат всяка седмица в компанията ви?
С реална извадка от видовете, които обработвате, може да се оцени какъв дял би минал без намеса и какво би трябвало да се проверява. Преглеждаме го с вас.
Заявете анализ на процеситеNexum Blog
Свързани статии
25 юни 2026
Цена на индустриален робот: ръководство
Колко струва индустриален робот през 2026: цена на рамото по тип, марка, товар и обхват, разходи за интеграция и ROI. Ясно ръководство за бюджет.
19 юни 2026
BMS срещу EPMS: разлики и кой ви трябва
Разлика между BMS и EPMS: обхват, скорост, качество на енергията и кое е нужно на завода ви. Ясно ръководство за сгради и индустрия.
29 юни 2026
IEC 61439: стандартът за електротабла
Какво е IEC 61439, как се различава проверката на проекта от индивидуалната и защо определя безопасността на вашето електрическо табло.