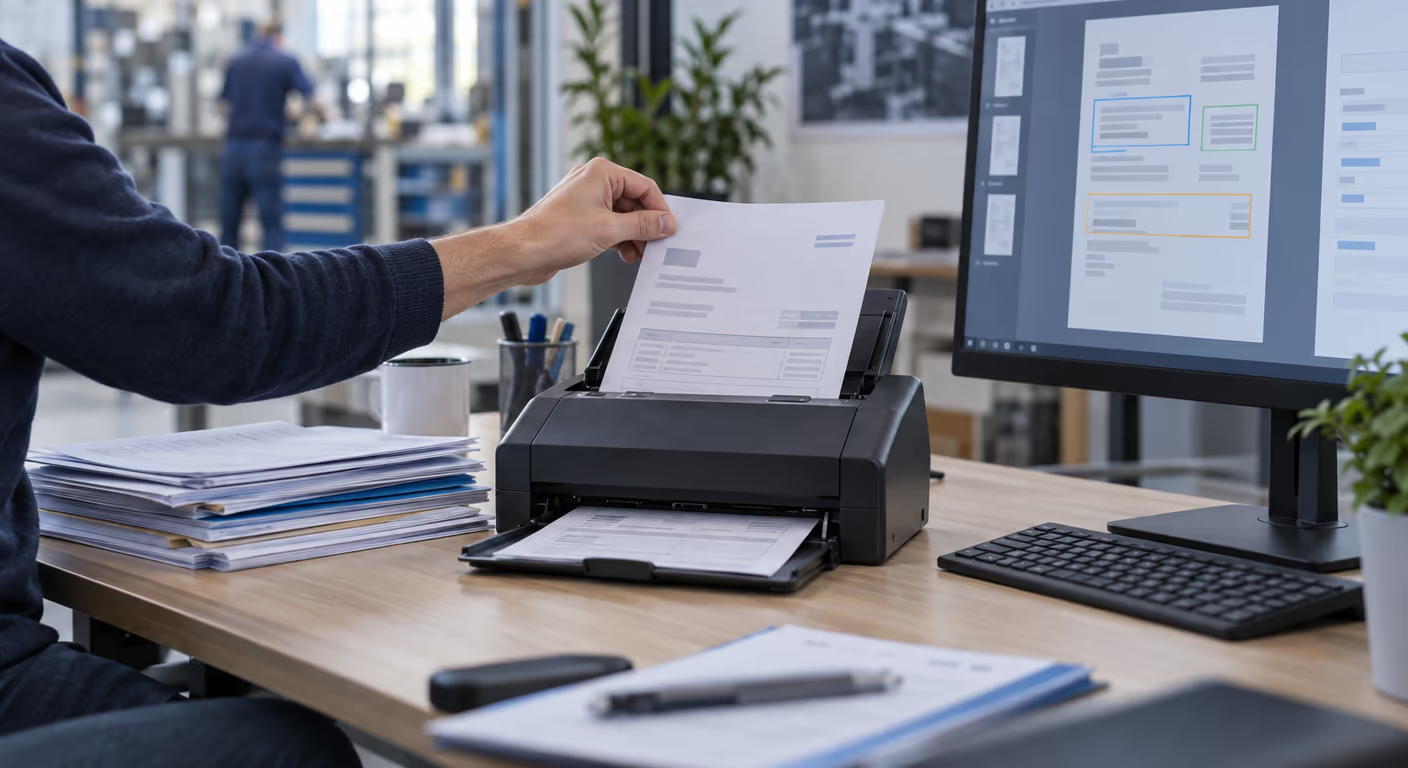
Procesamiento inteligente de documentos (IDP)
· por Panayot Dimkov
El procesamiento inteligente de documentos (IDP) usa IA para hacer con un documento lo que hoy hace una persona: clasificarlo, extraer los datos que importan, validarlos contra los sistemas de la empresa y decidir adónde van, con un nivel de confianza por campo que indica cuándo hace falta revisión humana. El OCR es solo una pieza de ese proceso: convierte la imagen de un texto en caracteres, pero no entiende qué documento tiene delante, ni sabe cuál de esos números es el total, ni se da cuenta de que falta un dato.
1Las cuatro capas del procesamiento inteligente de documentos
Un procesamiento completo hace cuatro cosas distintas, y conviene distinguirlas porque cada una tiene su dificultad.
2Los documentos que hay en una empresa cualquiera
Se piensa en facturas porque son las más visibles, pero el volumen real está repartido.
| Documento | Qué se extrae y para qué |
|---|---|
| Albaranes | Número de pedido, referencias y cantidades, para cotejar con el pedido y dar por buena la recepción |
| Certificados y seguros | Titular, alcance y fecha de caducidad, para avisar antes de que venzan en vez de descubrirlo cuando hace falta |
| Contratos | Partes, importe, duración, preaviso de renovación. La renovación automática no deseada es un clásico caro |
| Partes de trabajo | Horas, materiales y firma del cliente, a menudo manuscritos y fotografiados con el móvil |
| Justificantes de gasto | Importe, fecha, concepto e impuesto, para liquidar sin que nadie transcriba tíquets |
La lista importa porque cambia el orden de prioridades. Un aviso automático de caducidad de certificados puede valer más que ahorrar minutos en facturas, y suele ser más fácil de montar.
3IDP frente a OCR: por qué las plantillas dejaron de servir
El OCR con plantillas funciona por coordenadas: aprende que en los documentos del proveedor A el total está abajo a la derecha. Es preciso y rápido mientras el documento no cambie.
- Cada formato nuevo es trabajo de configuración. Con veinte emisores es asumible; con doscientos, alguien se dedica solo a eso.
- Un rediseño rompe la plantilla. El proveedor cambia su logotipo de sitio y la extracción empieza a fallar sin avisar.
- No entiende variantes. Un albarán de dos páginas, una tabla partida o una nota manuscrita al margen se sale del molde.
- No sabe lo que no sabe. Devuelve lo que hay en esa posición, sea o no el dato correcto.
Un modelo de lenguaje con visión trabaja al revés: interpreta el documento como lo haría una persona, y por eso maneja formatos nuevos sin configuración previa. A cambio es menos determinista, y de ahí viene el punto siguiente.
4El nivel de confianza es el dato que importa
La pregunta que todo el mundo hace —«¿qué precisión tiene?»— es la menos útil. La buena es: ¿sabe el sistema cuándo no está seguro?
El umbral no es universal: se fija por campo y con una muestra real de documentos, más exigente para una fecha de caducidad o un importe que para una referencia interna. Y una confianza alta no garantiza que el dato sea correcto; por eso la capa de validación sigue haciendo falta.
El corolario práctico es que la revisión humana no es un fallo del diseño, es parte del diseño. Y que la interfaz de revisión importa tanto como el modelo: si corregir un campo cuesta tres clics y ver el documento al lado, la gente lo hace; si obliga a abrir dos pantallas, no.
5Los casos difíciles, con expectativas realistas
6Cómo elegir el primer caso
Cuatro criterios, en este orden:
Preguntas frecuentes
¿Qué diferencia hay entre OCR y procesamiento inteligente de documentos?
El OCR convierte imagen en texto: reconoce caracteres. El procesamiento inteligente añade tres cosas encima: entender de qué tipo de documento se trata, localizar los campos con sentido aunque cambien de sitio, y validar lo extraído contra los datos de la empresa. El OCR es un componente del segundo, no un sustituto.
¿Hace falta entrenar el sistema con mis documentos?
Con los modelos actuales, no para empezar. Reconocen tipos de documento comunes sin configuración previa, que es la gran diferencia frente a las plantillas. Lo que sí conviene es afinar con ejemplos propios los tipos específicos de tu sector y las reglas de validación, que son las que dependen de tu negocio.
¿Puede procesar documentos en varios idiomas?
Sí, en los idiomas habituales y sin configuración distinta para cada uno. Es una diferencia relevante frente a las soluciones basadas en plantillas, donde cada idioma solía implicar una configuración aparte. Para una empresa con proveedores o clientes en varios países, esto elimina buena parte del trabajo de mantenimiento.
¿Dónde se procesan los documentos?
Depende del servicio que se use, y es una pregunta que hay que hacer antes de firmar nada. Si los documentos contienen datos personales —y casi todos los contienen— hay que saber si el tratamiento sale del Espacio Económico Europeo y con qué garantía, y tener el contrato de encargado del tratamiento. Lo desarrollamos en automatizar procesos sin incumplir el RGPD.
¿Qué pasa con los documentos antiguos en papel?
Digitalizarlos en masa solo compensa si de verdad se van a consultar. Suele ser más razonable procesar desde hoy hacia adelante y digitalizar el histórico bajo demanda, cuando alguien lo necesite. Una excepción: si hay obligación de conservación y el archivo físico es un riesgo, entonces la digitalización tiene otra justificación.
En definitiva
El salto respecto al OCR no está en leer mejor, está en entender el documento y en saber cuándo no se está seguro. Eso permite dejar de configurar plantillas y empezar a diseñar un flujo con umbrales, validaciones y una cola de revisión pequeña.
Y conviene mirar más allá de las facturas: los certificados que caducan, los contratos que se renuevan solos y los partes de trabajo que nadie transcribe suelen dar más retorno y ser más fáciles de abordar. Así lo planteamos en automatización de procesos con IA.
¿Qué documentos entran cada semana en tu empresa?
Con una muestra real de los tipos que manejáis se puede estimar qué porcentaje se procesaría sin intervención y qué haría falta validar. Lo revisamos contigo.
Solicitar análisis de procesosNexum Blog
Artículos relacionados
17 jun 2026
SCADA vs HMI: diferencias y cuál elegir
Diferencia entre SCADA y HMI: alcance, datos históricos, alarmas, acceso remoto y cuándo necesitas cada uno. Guía clara de un integrador industrial.
31 jul 2026
Cómo elegir fabricante de cuadros eléctricos industriales
Cómo elegir fabricante de cuadros eléctricos industriales: IEC 61439, FAT, oficina técnica, las 7 preguntas clave y las señales de alarma en presupuestos.
9 jul 2026
Tendencias de la Industria 4.0 en 2026
Las 8 tendencias de la Industria 4.0 en 2026 que sí mueven el indicador: IA en planta, visión artificial, gemelos digitales, cobots, edge y NIS2.